Le 9 octobre, Microsoft a lancé Microsoft-Decision-1 dans Foundry : un modèle qui n’écrit jamais la moindre phrase. Posez-lui une question avec une liste fermée d’options, et il renvoie une probabilité par option. C’est tout. Pas de prose, pas d’explication, et le verdict tombe en 85 millisecondes environ. Bienvenue dans une nouvelle famille : les decision models. Spoiler : ils ne viennent pas remplacer votre chatbot, et les comprendre, c’est pas sorcier.
L’aiguilleur dans son poste de commande
Imaginez une gare. Le LLM avec lequel vous discutez tous les jours, c’est le brillant consultant installé dans le hall : posez n’importe quelle question, vous recevez une page bien argumentée. Utile, mais lent et cher ; et vous n’avez pas besoin d’une dissertation pour décider sur quelle voie envoyer le train 4812.
Ce travail, c’est celui de l’aiguilleur dans son poste de commande. Il ne rédige pas de rapports : il regarde la situation et tire un levier parmi trois. Vite, de façon répétable, des milliers de fois par jour. Un decision model, c’est exactement ça : un petit modèle spécialisé (Decision-1 est un Qwen3.5-9B post-entraîné, environ 9 milliards de paramètres) conçu pour choisir une option, pas pour parler.
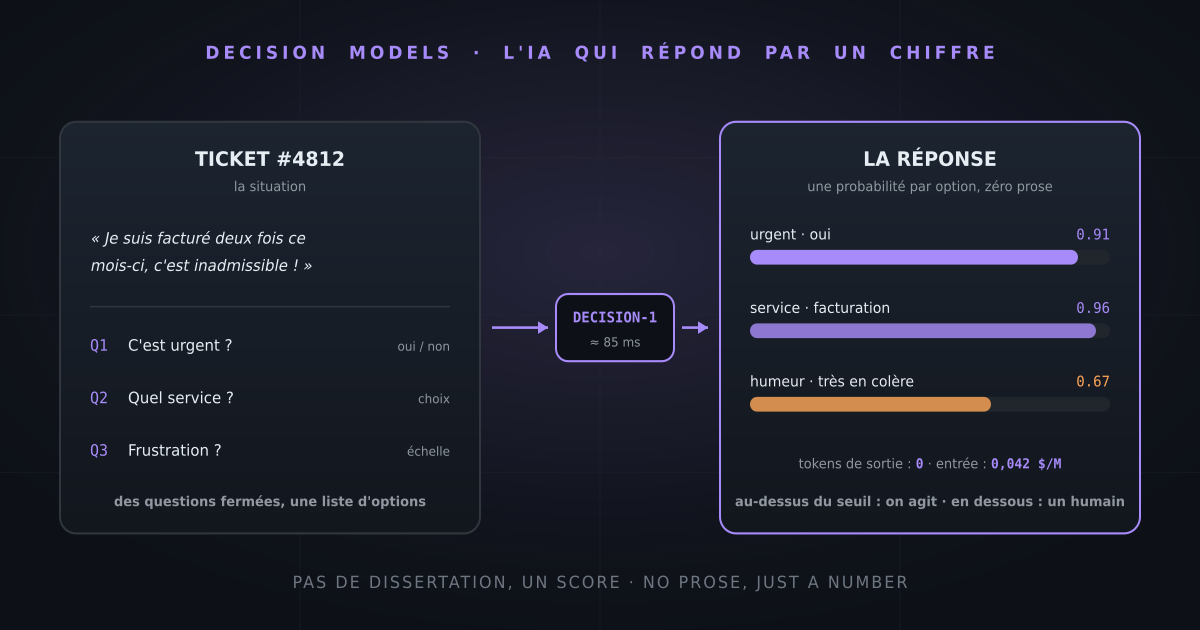
Le contrat est strict. Vous envoyez une situation (jusqu’à 32 768 tokens de texte), une question et une liste fermée d’options : oui/non, choix multiple, échelle de notation ou grille d’évaluation. Vous recevez une probabilité pour chaque option, en JSON brut. Tokens de sortie : zéro. Ce qui explique le tarif : 0,042 $ par million de tokens d’entrée, sortie gratuite.
Une probabilité, pas une impression
Le mot intéressant dans l’argumentaire de Microsoft, c’est calibré. Un 90 % calibré doit être juste environ neuf fois sur dix ; un présentateur météo qui annonce 90 % de pluie et reste au sec une fois sur deux n’est pas calibré, juste sûr de lui. C’est cette propriété qui permet au logiciel d’agir directement sur le score : approuver automatiquement au-dessus de 0,95, envoyer à un humain entre 0,60 et 0,95, rejeter en dessous. Le modèle peut même répondre « impossible à dire » si vous lui offrez cette option : une façon intégrée de s’abstenir plutôt que de deviner.
Un exemple concret
Un ticket de support arrive. Un seul appel, trois questions :
Situation : Ticket #4812 — « Je suis facturé deux fois ce mois-ci, c'est inadmissible ! »

Q1 (oui/non)  C'est urgent ?            → oui : 0,91 · non : 0,09
Q2 (choix)    Quel service ?            → facturation : 0,96 · technique : 0,03 · ventes : 0,01
Q3 (échelle)  Niveau de frustration ?   → calme : 0,02 · frustré : 0,31 · très en colère : 0,67
Trois leviers tirés en une passe, chacun avec sa confiance. Votre code aiguille le ticket vers la facturation, le marque urgent et remonte sa priorité parce que le client fulmine. Aucune dissertation de LLM n’a été maltraitée dans l’opération.
Ce format colle à une bonne partie de la plomberie des systèmes IA : le routing des demandes vers le bon modèle ou le bon parcours, la classification et l’étiquetage de données, les guardrails qui notent l’appel d’outil proposé par un agent avant son exécution (continuer, arrêter, ou passer la main à un humain), et la notation de réponses IA selon une grille, le rôle qu’on appelle d’habitude LLM-as-judge.
Les chiffres (avec les astérisques)
L’évaluation de Microsoft couvre 36 benchmarks et 147 137 questions :
| Modèle | Précision moyenne | Latence médiane |
|---|---|---|
| Microsoft-Decision-1 | 83,5 % | 85 ms |
| Jev 1.13 | 82,3 % | 240 ms |
| Quyet-1.0-Large | 81,9 % | 380 ms |
| GPT-6 Luna Decisions | 79,4 % | 300 ms |
| H2O-Lightning-4B | 77,2 % | 210 ms |
L’argument du coût est le plus bruyant : le graphique de Microsoft chiffre la classification d’un million de textes à environ 11 $ avec Decision-1, contre environ 2 434 $ avec GPT-6 Sol. En interne, l’équipe Xbox Research dit trier les retours des joueurs 14 fois plus vite et 200 fois moins cher qu’avec GPT-6 Sol.
Maintenant, les astérisques, parce que l’honnêteté est la règle de la maison. Tous ces chiffres sont auto-rapportés par Microsoft, pas reproduits indépendamment ; mesurée via OpenRouter, la latence médiane ressemble plutôt à 190–270 ms qu’à 85. Le tableau comparatif d’origine omettait Jev, le decision model le plus utilisé (ajouté ensuite dans une note de l’éditeur), et le graphique de prix compare au vaisseau amiral d’OpenAI plutôt qu’à ses déclinaisons moins chères. Et sur la calibration, la métrique qui compte le plus pour automatiser par seuils, Decision-1 est en réalité troisième (92,2), derrière Jev (93,7) et Quyet (93,1).
Ce qu’il ne fera jamais
Un decision model ne génère pas de texte, donc il n’explique rien. Vous recevez « 0,91 » sans le pourquoi ; s’il vous faut une justification, vous l’associez à un LLM. Une question mal posée renvoie quand même un score à l’air confiant. La qualité baisse hors de l’anglais. Et Microsoft lui-même précise qu’il ne doit pas être le seul décideur pour des choix lourds concernant des personnes : crédit, emploi, logement, assurance, santé. Là, le score est une donnée pour un humain, jamais le verdict. Gardez vos evals et votre humain dans la boucle.
En résumé
| Question | Réponse |
|---|---|
| C’est quoi, un decision model ? | Un petit modèle qui choisit parmi des options fixées et renvoie une probabilité par option |
| Il produit quoi ? | Des nombres en JSON, rien d’autre : ni texte, ni explication |
| Ça coûte combien ? | 0,042 $ par million de tokens d’entrée ; sortie gratuite (il n’y en a pas) |
| Où il brille ? | Routing, classification, guardrails d’agents, LLM-as-judge, triage |
| Où il n’a pas sa place ? | Génération, questions ouvertes, et décisions lourdes concernant des personnes |
| La réserve | Benchmarks auto-rapportés ; calibration derrière Jev |
Le schéma à retenir : gardez le gros LLM pour les conversations et la rédaction, et placez un aiguilleur devant (et autour de) lui pour les mille petits oui/non que votre système tranche chaque heure. L’un tire les leviers, l’autre écrit les rapports. À deux, la gare tourne plutôt bien : c’est pas sorcier.
Sources : Microsoft, introducing Microsoft-Decision-1 · Catalogue Microsoft Foundry · eesel, Microsoft-Decision-1 explained · OrcaRouter, a model that answers with a number.